Les éditions Boréal abandonnent pour de bon la promotion du livre d’un auteur québécois accusé d’avoir utilisé l’intelligence artificielle dans son roman et d’avoir menti à ce sujet. Vous ne savez peut-être pas que la scène littéraire à l’échelle mondiale était à couteux tirés autour du roman «C’était ça ou mourrir», de Thélyson Orélien. C’est un roman de fiction qui tourne autour du thème de la migration de l’auteur depuis Haïti. L’oeuvre a connu un succès fou : elle a remporté plusieurs prix et a été en lice pour Goncourt.
Je dis bien «a été», au passé, parce que la presse étincelante du livre a vite été éclipsée par un gros nuage. Des accusations portées contre l’auteur avancent qu’il aurait écrit son livre avec l’intelligence artificielle, ce qu’Orélien a toujours nié. L’affaire a pris une tournure mondiale. Il y a quelques semaines, Boréal, l’éditeur du livre au Québec, a annoncé qu’il se distançait finalement de son poulain : des traces de balises d’intelligence artificielle ont bien été trouvées dans certaines versions du roman et le lien de confiance entre l’éditeur et l’auteur en est brisé. Mais pourquoi l’histoire n’a-t-elle pas été réglé du moment que le détecteur Pangram a généré un rapport disant que le roman était fait par l’IA?
Avant «C’était ça ou mourir», d’autres auteurs accusés d’utiliser l’IA
Permettez-moi un court aparté sur le contexte social autour de la discussion. Ce n’est pas la première fois qu’un livre à succès baigne dans la controverse à cause de soupçons d’usage de l’IA. L’autrice Mia Ballard a décroché un contrat très lucratif avec la maison Hachette pour la publication de son livre «Shy Girl», jusqu’à ce que les discussions du lectorat autour de certaines tournures qui sonnaient très «IA» viennent aux oreilles des parties prenantes. Le contrat a ensuite été annulé par Hachette, et l’autrice a nié sa responsabilité tout en faisant miroiter la possible faute d’un tierce parti qui faisait de la révision. Dans cette histoire comme dans celle de «C’était ça ou mourir», l’outil de détection Pangram a servi à apporter de l’eau au moulin en contexte de suspicion d’utilisation d’IA.
Une autre ressemblance dans les deux situations me saute aux yeux. Thélyson Orélien et Mia Ballard sont des personnes Noires. Leur position en tant que minorité dans le monde de la littérature à succès fait d’eux en quelques sortes des transfuges de classe. Ça vient augmenter leur vulnérabilité aux conséquences quand une faute réelle ou alléguée vient atteindre leur status. La position d’artiste elle-même fait l’objet de toutes sortes d’attaques dans notre société en contexte de montée de la droite, et de rapides changements technologiques et sociaux. J’aimerais vous parler à titre d’exemple du traitement qu’ont fait les médias de Laura-Ève Lambert, une autre autrice québécoise qui a été jadis en lice pour le Goncourt pour son roman «Que notre joie demeure». Le livre n’était pas au milieu d’une controverse sur l’IA, mais on blâmait l’écrivaine pour son recours à une soi-disante relectrice du sensible. C’était en fait une directrice littéraire, Chloé Savoie-Bernard, qui a tout simplement offert ses services. Une intervention banale et courante dans l’industrie. Les détracteurs associaient ça a une censure woke par rapport aux questions raciales.
Dans le cas des trois romans dont j’ai parlé, les thèmes d’authenticité, de la genèse de l’oeuvre littéraire et de l’anxiété de classe raciale et sociale se bousculent. Et dans toutes ces histoires, on voit comment les artistes sont de bonnes cibles dans le champ de bataille de la culture war. On essaie de faire tomber les artistes, et les grosses maisons d’édition ou compagnie de technologie restent pour l’essentiel indemnes.
Pangram, cet outil de détection de l’IA au milieu de toutes ces controverses
Que les accusations d’utilisation de l’IA soient motivées ou non par un projet politique, reste que ça serait drôlement utile qu’un outil permette de déterminer avec certitude si un texte a été généré par l’IA. Dans le cas de «Shy Girl» et «C’était ça ou mourir», l’outil de détection Pangram a plutôt généré encore plus de confusion.
Le service Pangram a déterminé que le livre «Shy Girl» était fait à environ 78% par l’IA. Pour « C’était ça ou mourir » de Thélyson Orélien, ça a grimpé à 99% de texte de synthèse. Un nombre aussi haut a soulevé mon scepticisme quant à la fiabilité du détecteur. J’ai donc fait ma propre expérience, comme de nombreuses personnes.
D’abord, j’ai soumis au détecteur un texte entièrement conçu par l’IA. Un texte en français, généré directement à partir de ma machine sur un modèle langagier large méconnu et plutôt léger. Le texte a bien été détecté par Pangram comme 100 % IA. Bravo.
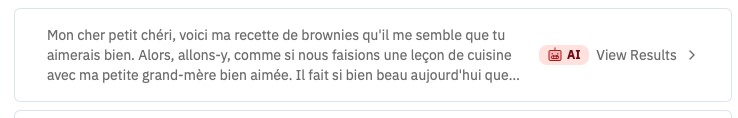
Pour la suite de l’expérience, j’ai prolongé le texte de synthèse en livrant d’autres instructions à l’outil génératif sur mon mac. J’ai tout recopié sur Pangram. Verdict : 100 % de texte de synthèse. Oups! Pangram s’est trompé.
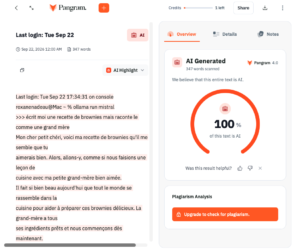
Le texte que j’ai recopié comporte bien du texte de synthèse, mais ça inclue aussi mes instructions à la machine, qui elles sont bien de ma plume. C’est impossible que ce test puisse être précis dans l’analyse de mon texte fait partiellement par une humaine.
Pourquoi ces détecteurs d’IA ne sont pas fiables
Les outils tiers de détection d’IA ne sont pas fiables. Pourtant, il y a eu une déclaration officielle d’Anthropic selon quoi son application de clavardage conversationnel pourrait éventuellement laisser une signature invisible dans le texte qui est généré, pour faciliter le traçage. Un détecteur d’IA tier ne pourrait-il pas tout simplement lire cette empreinte virtuelle? Difficilement. Et je vais vous expliquer pourquoi.
Quelle est la signature secrète qu’Anthropic souhaite laisser dans les textes?
Le service Claude d’Anthropic ou le Chat GPT de Open AI n’est pas juste une encyclopédie numérique qui recrache des bouts de textes déjà écrits par des humains par le passé. Il génère un texte en faisant des extrapolations mathématiques sur le prochain mot qui devrait sortir pour former une phrase, puis un texte.
La compagnie qui contrôle le modèle langagier large fait aussi toutes sortes d’interventions sur le résultat produit pour respecter des principes de modération. Parfois, on peut même avoir accès à la pondération donnée à chaque mot dans un modèle. Ça s’appelle un modèle open weight, à l’opposé d’un modèle close weight.
Voici une démonstration pour vous illustrer comment une IA génère un texte avec une empreinte numérique.
On donne une tâche à l’IA, décrire cette image d’un chien. C’est le genre de demande qui est faite à des services comme Chat GPT.
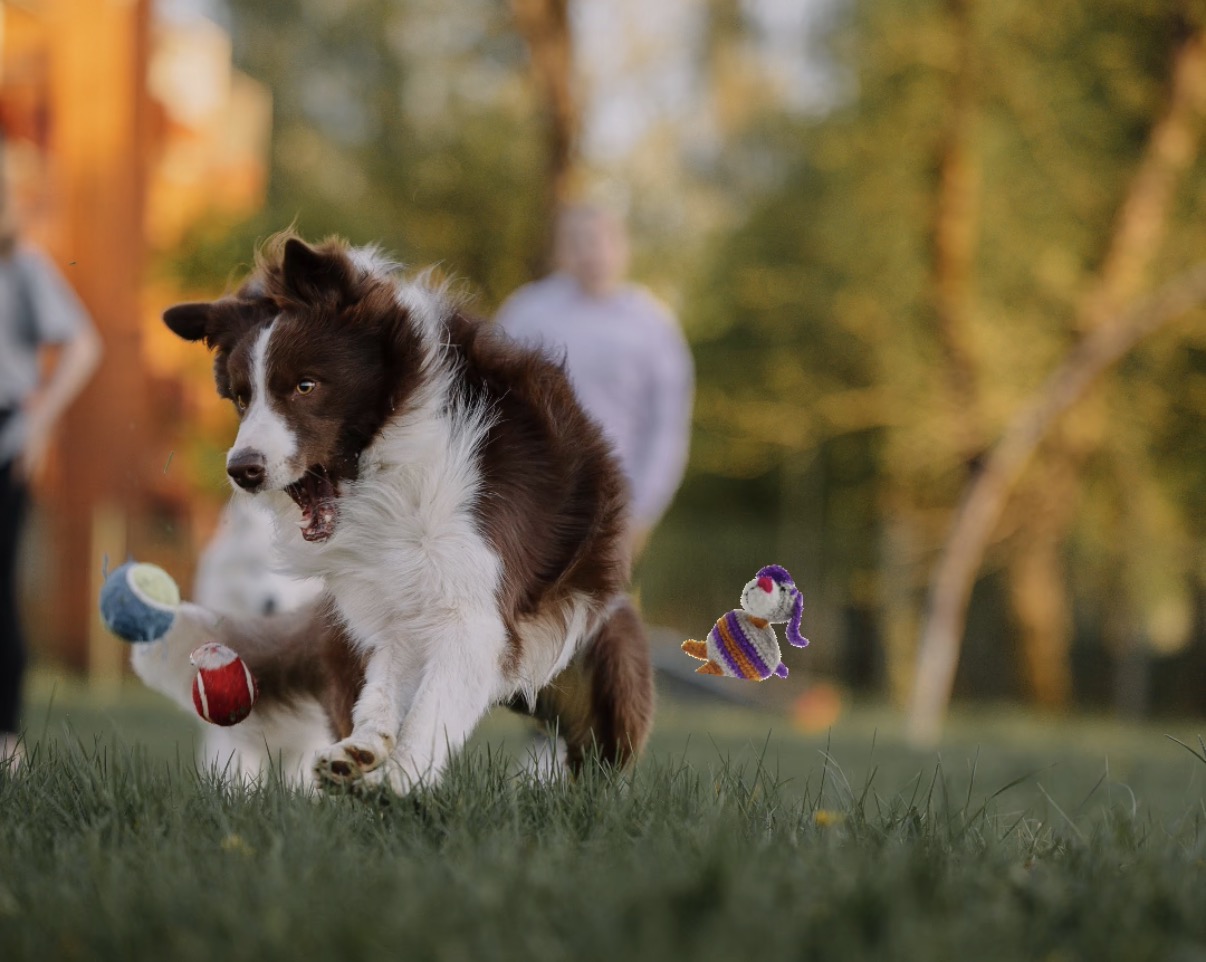
Crédit: Pexel, Elina Volkova.
Pour faire ce travail, l’IA a à sa disposition une quantité illimitée (pour les limitations du monde réel j’en utilise 7) de sacs qui contiennent ensemble une cinquantaine de jetons identifiés avec un mot.
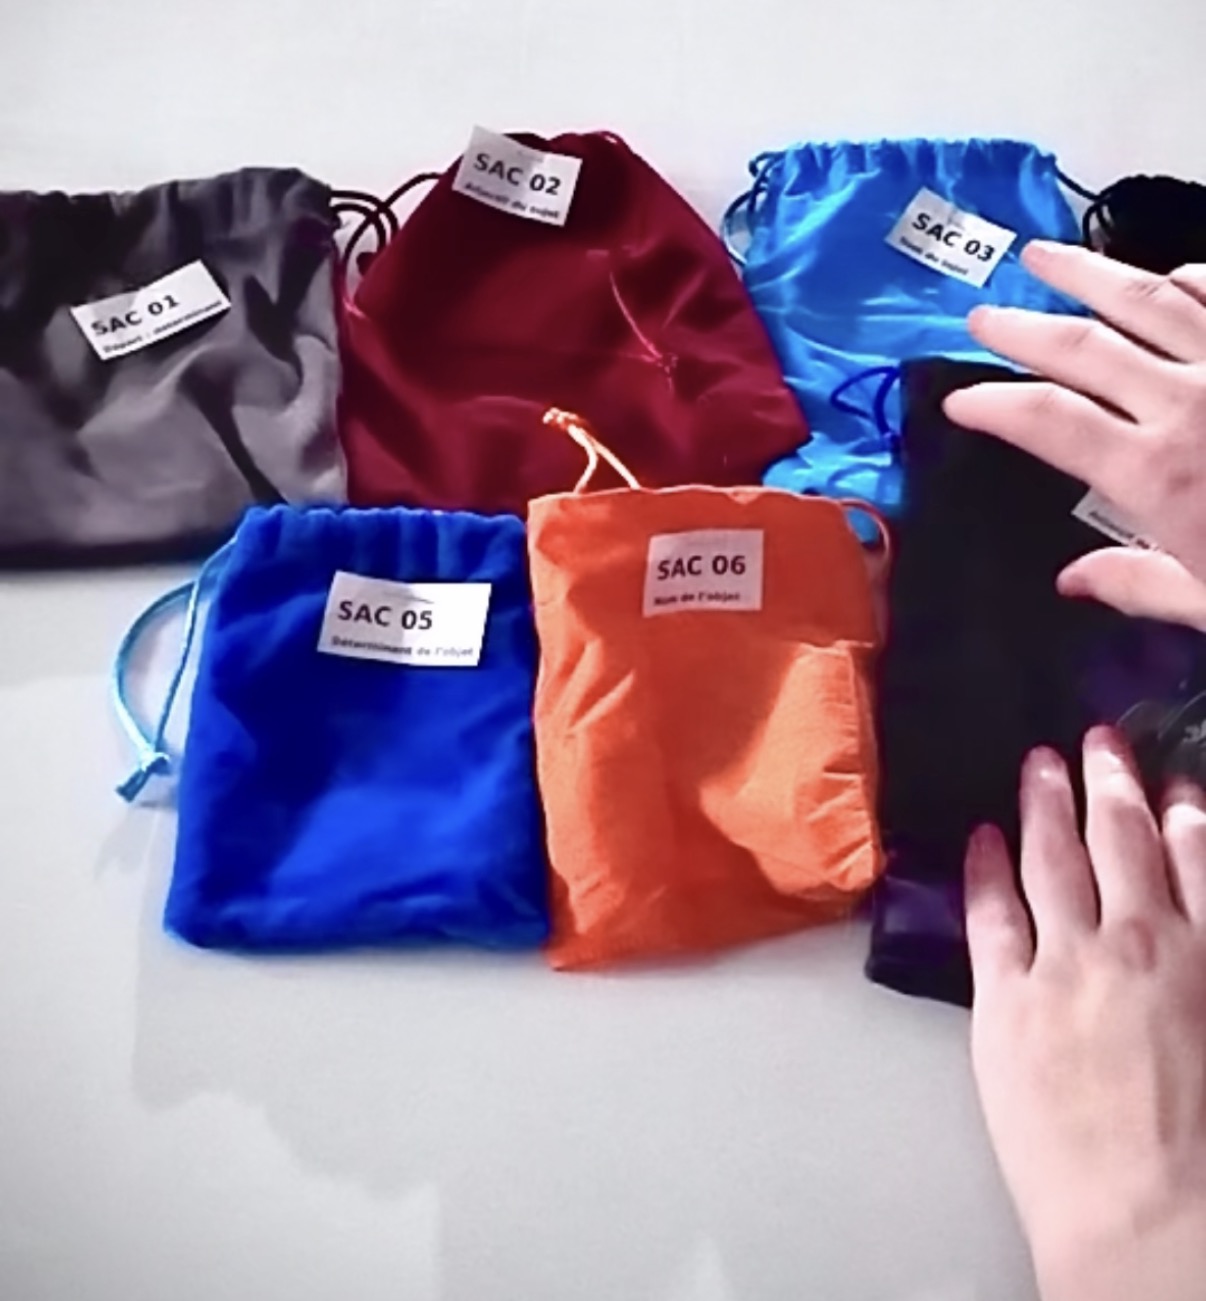
Une quantité illimitée de sacs comprenant des jetons.
En plus du mot, il y a des instructions pour indiquer dans quel sac piger le prochain jeton. Le même mot peut apparaître plusieurs fois dans un sac, et un sac peut contenir une famille de mot en particulier. C’est le modèle langagier large… en taille réduite.
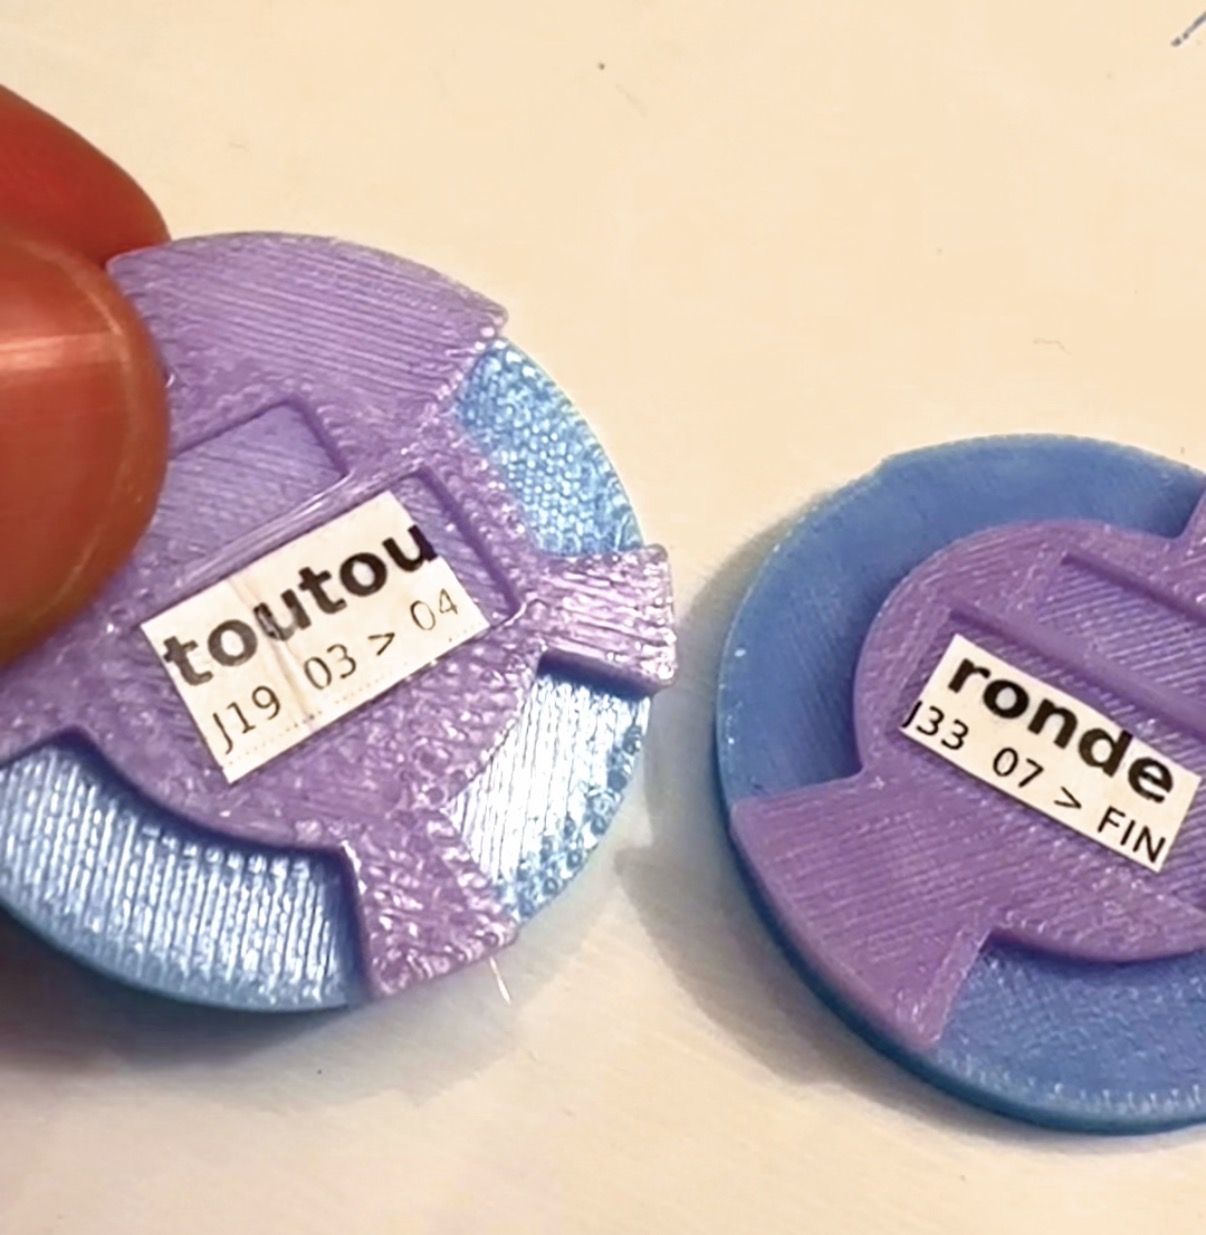
Un jeton avec son mot toutou, un autre jeton avec son mot ronde. Il y a des chiffres sous les mots.
L’IA pige son premier jeton dans le sac de départ.
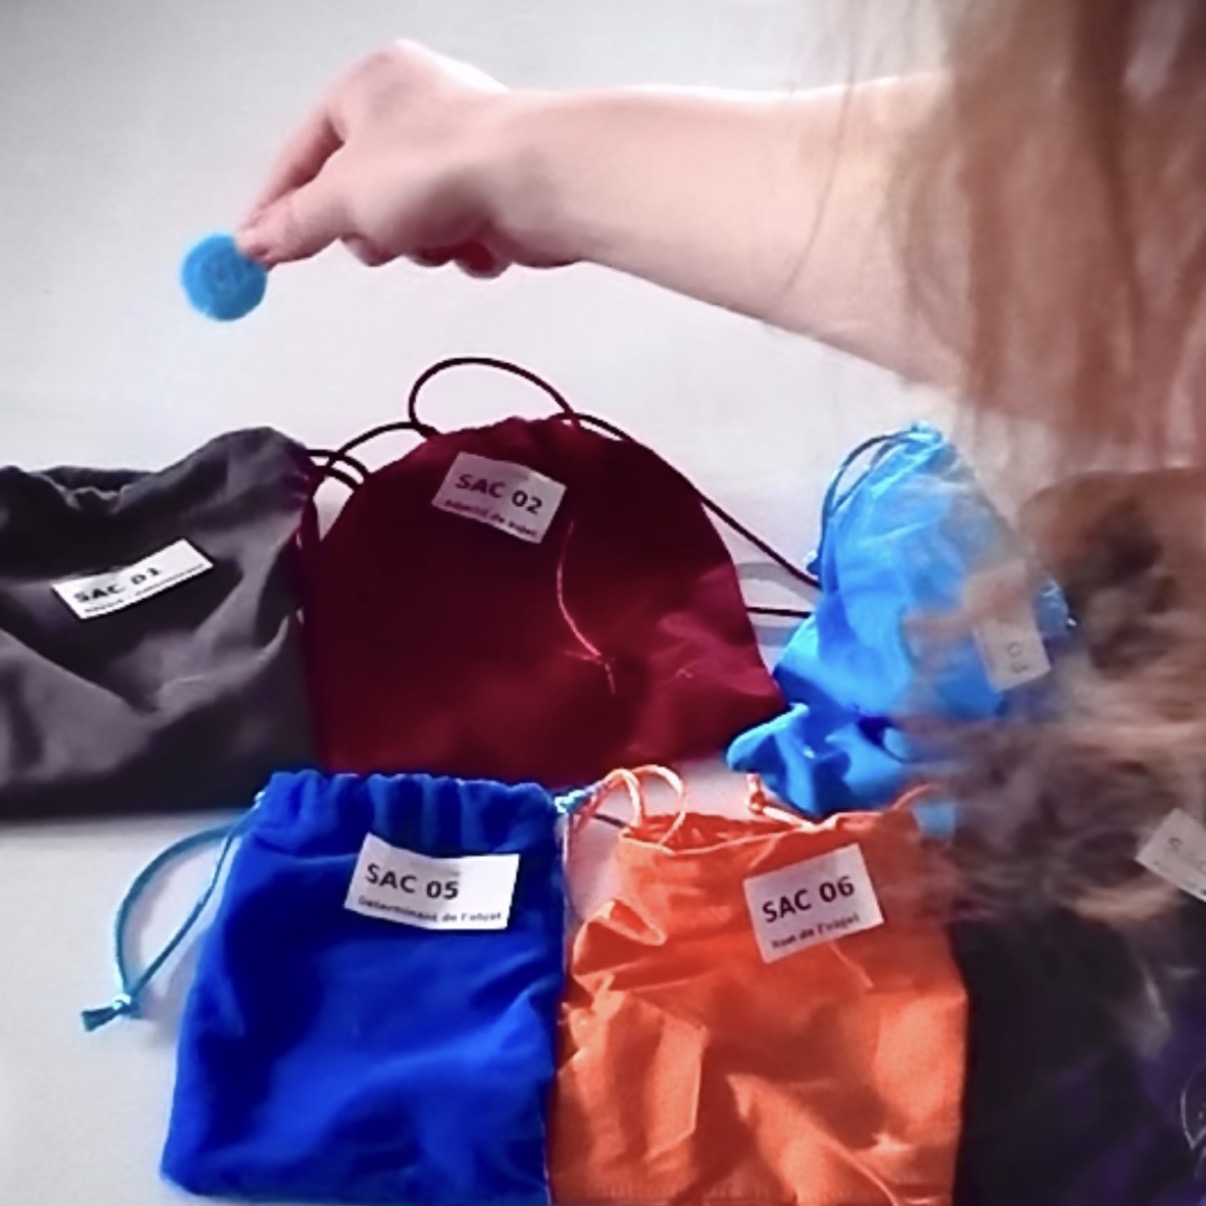
On débute la génération de la phrase en pigeant un jeton au hasard dans le sac de départ.
Puis, elle pige le prochain jeton selon l’instruction indiquée, et ainsi de suite jusqu’à atteindre un jeton de fin de phrase. Plus on avance dans la phrase, plus on risque de tomber sur un jeton de fin de phrase.
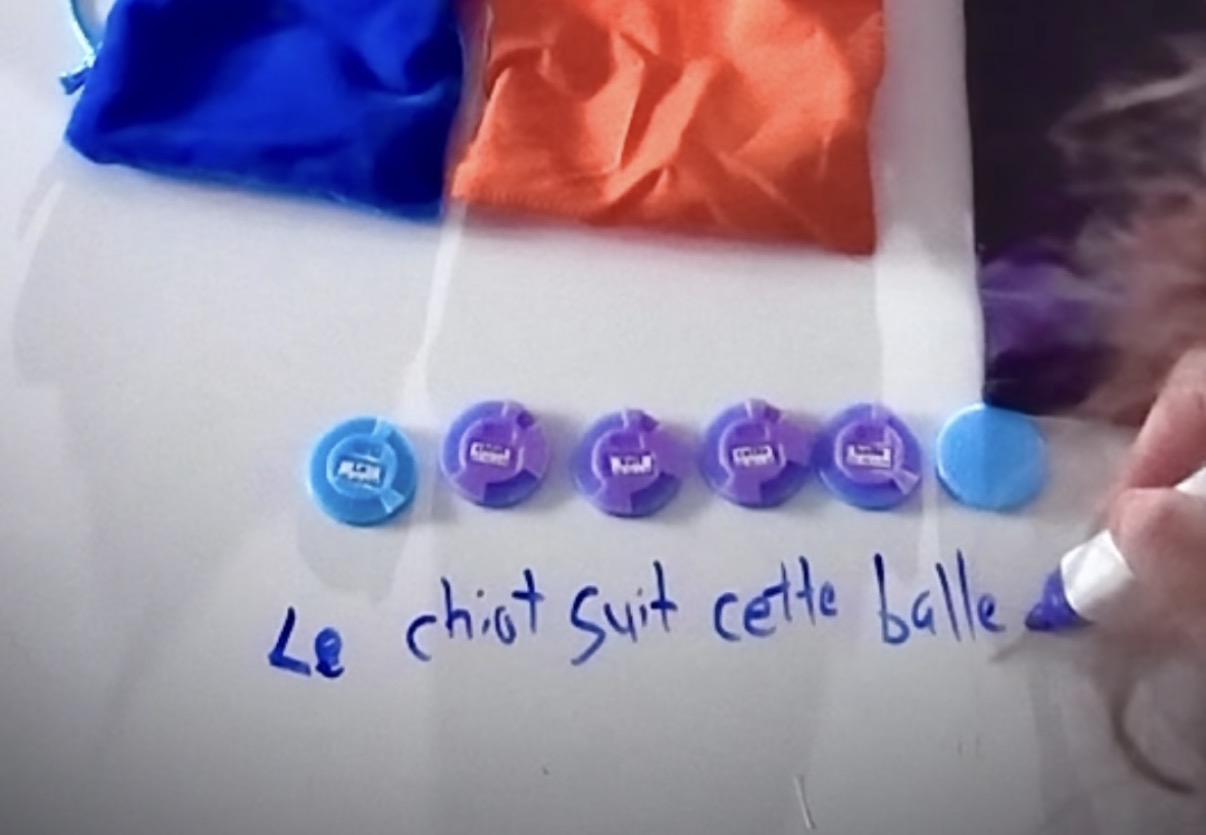
La pige de jeton à généré la phrase le chiot suit cette balle.
Pour le deuxième tour, on ajoute une signature numérique invisible.
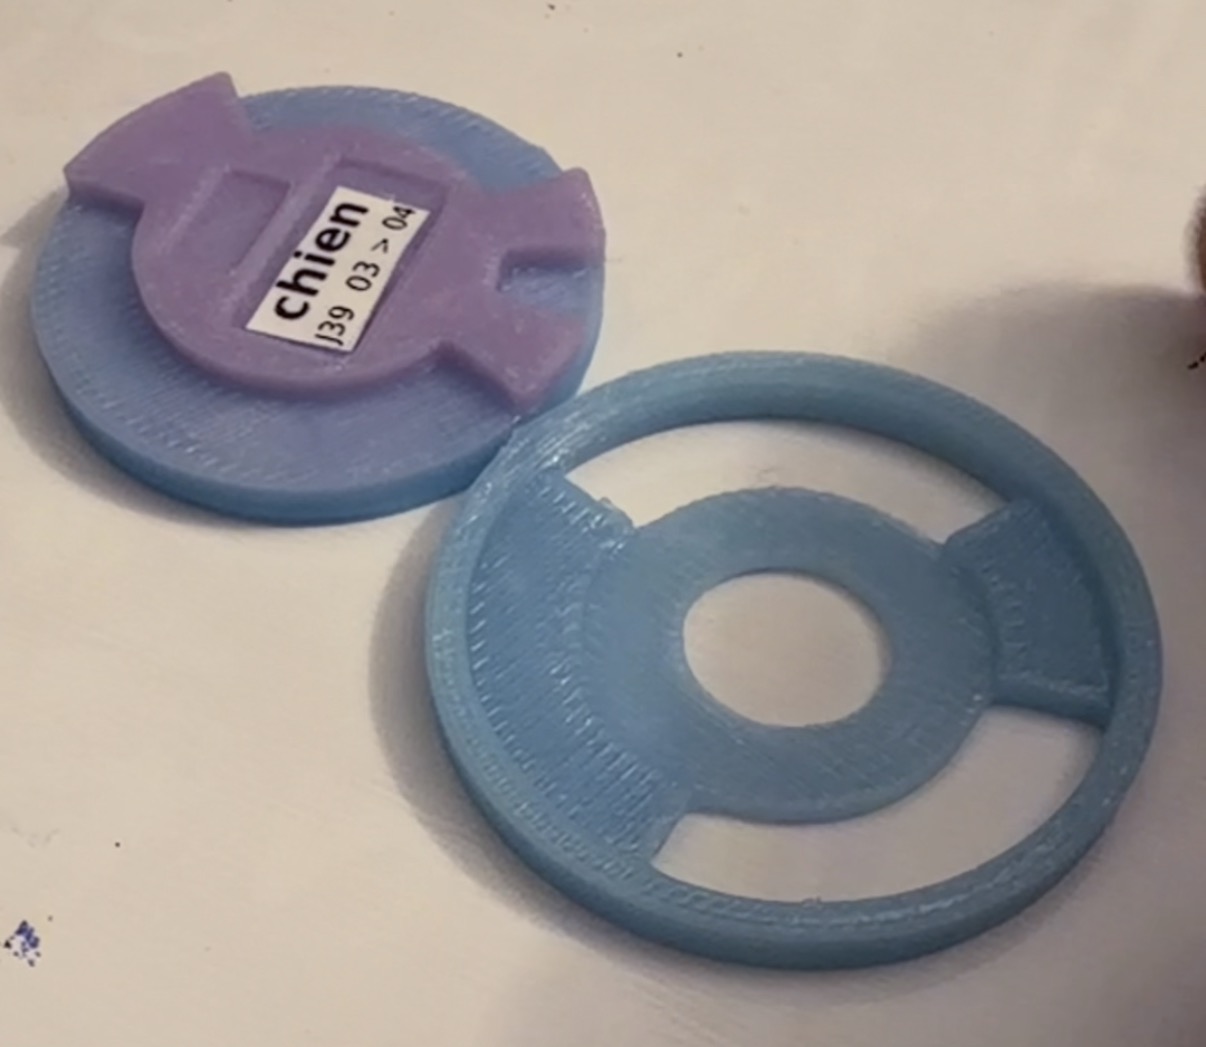
La clé est un socle physique qui peut s’emboiter avec un jeton ou ne pas parvenir à s’emboiter.
Si un jeton peut s’insérer dans la clé, on sait que c’est un jeton «vert», on le retourne à son sac d’où on l’a pris.
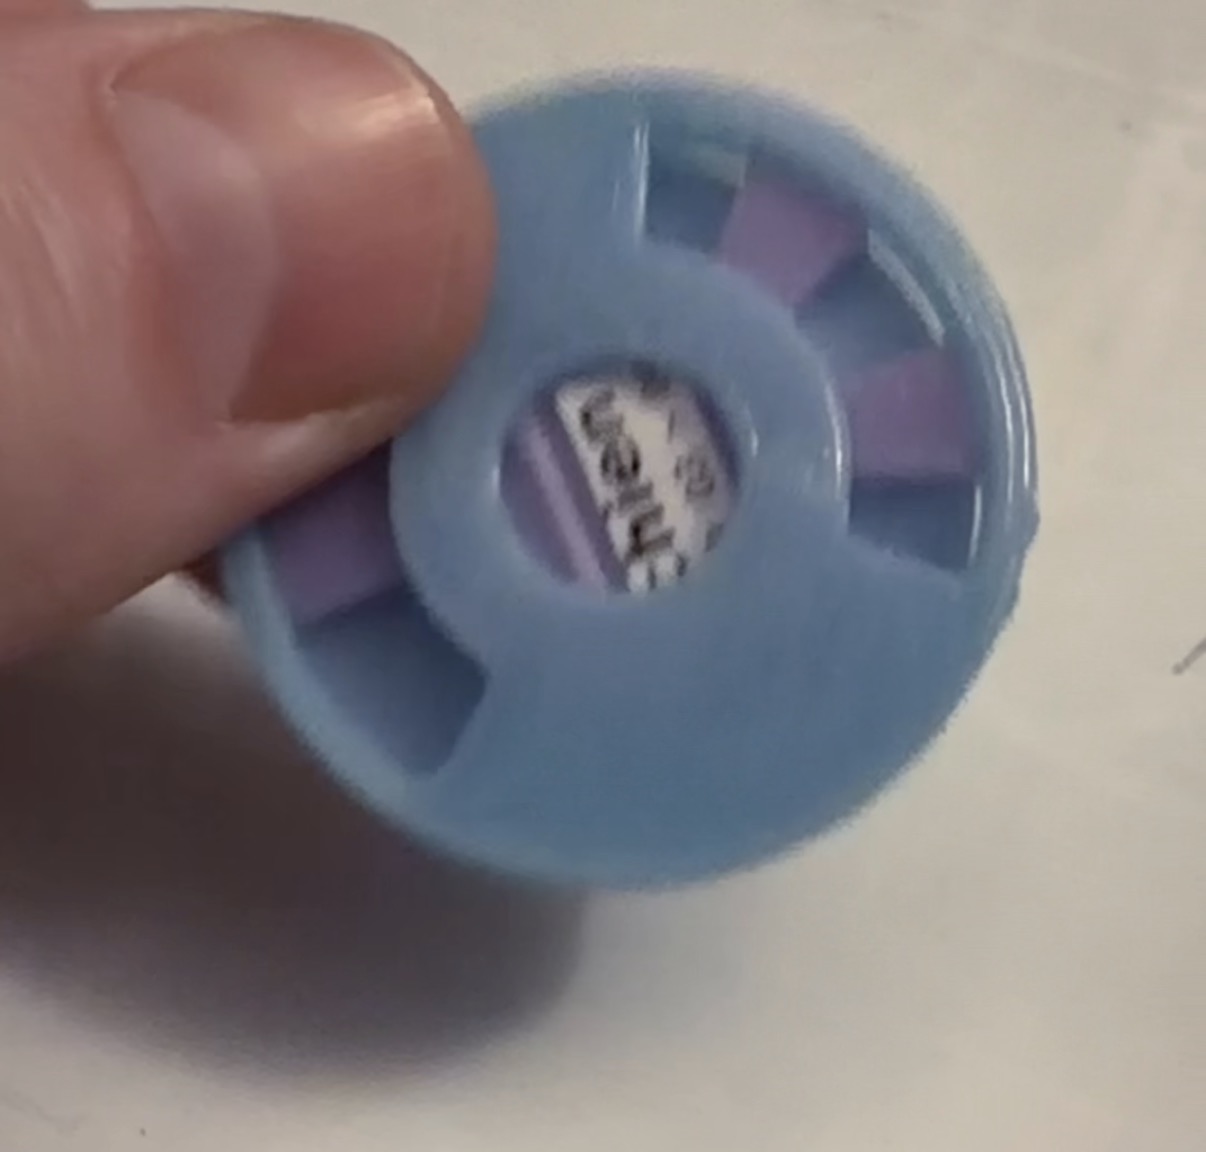
Un jeton est compatible avec la clé, il s’insère dans le socle.
Si le jeton ne peut pas s’insérer dans la clé, c’est un «jeton rouge», on le met dans un sac noir plutôt que dans son sac d’origine.
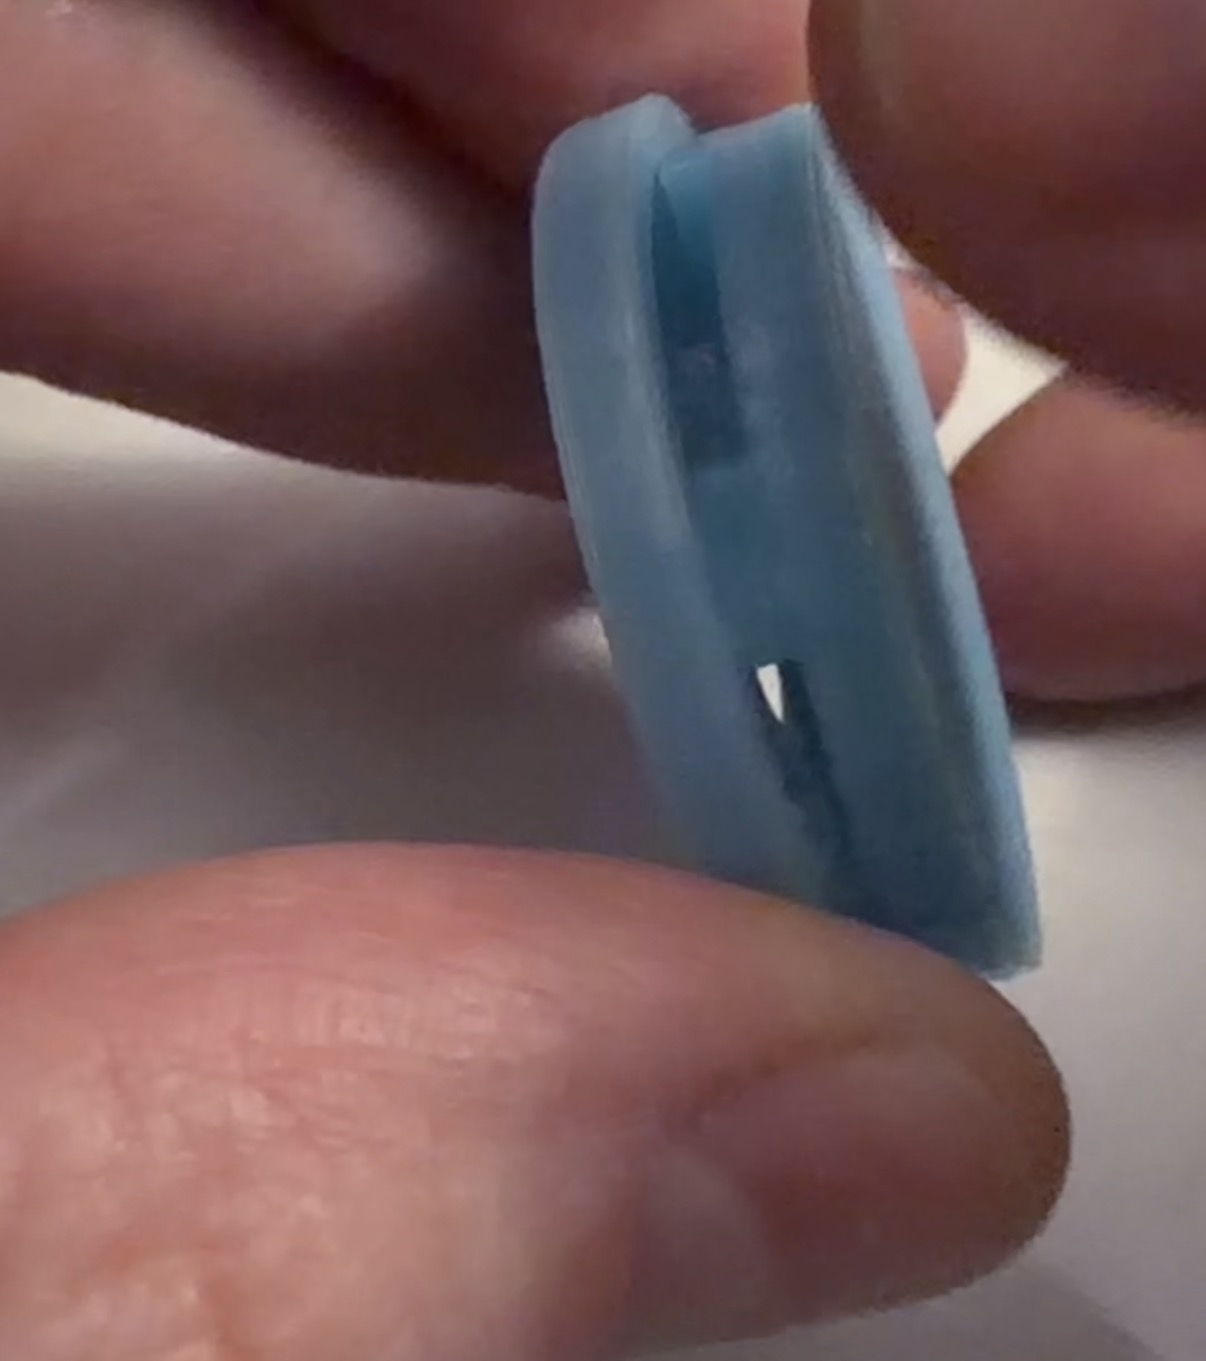
Un jeton ne peut pas être inséré dans la clé, il est incompatible avec elle.
La compagnie d’IA peut restreindre les jetons «rouges», ou augmenter la probabilité d’apparition des jetons «verts». C’est la différence entre une empreinte numérique stricte ou douce.
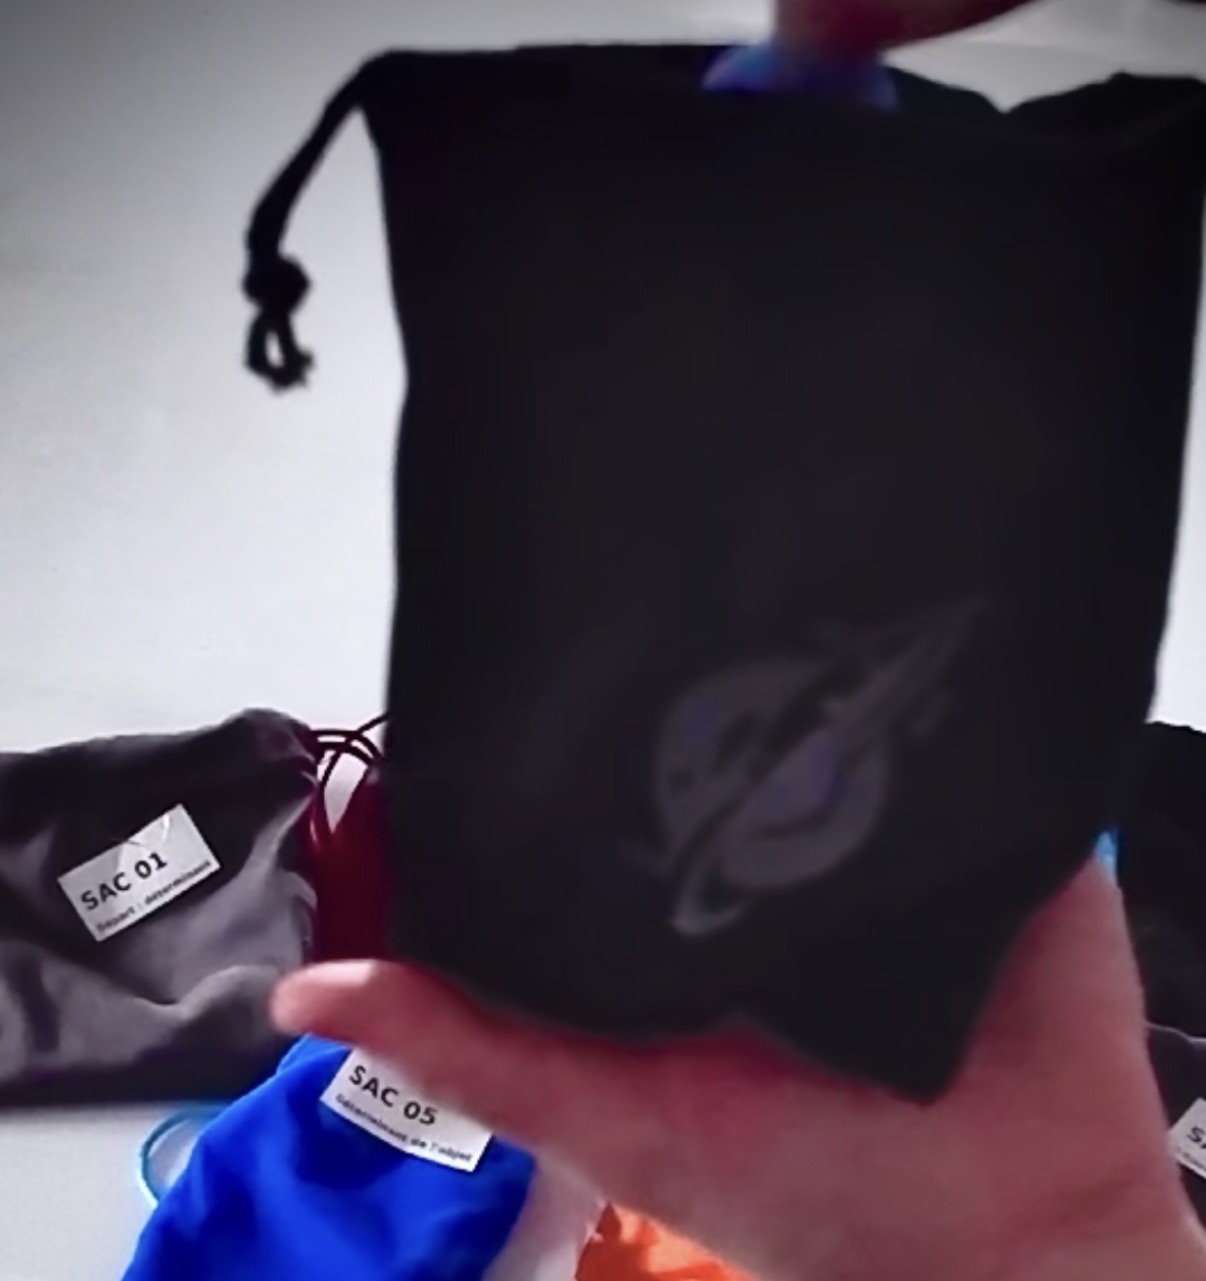
On glisse le jeton «rouges» (qui n’est pas compatible avec la clé) dans le sac noir.
Maintenant, on fait notre phrase.
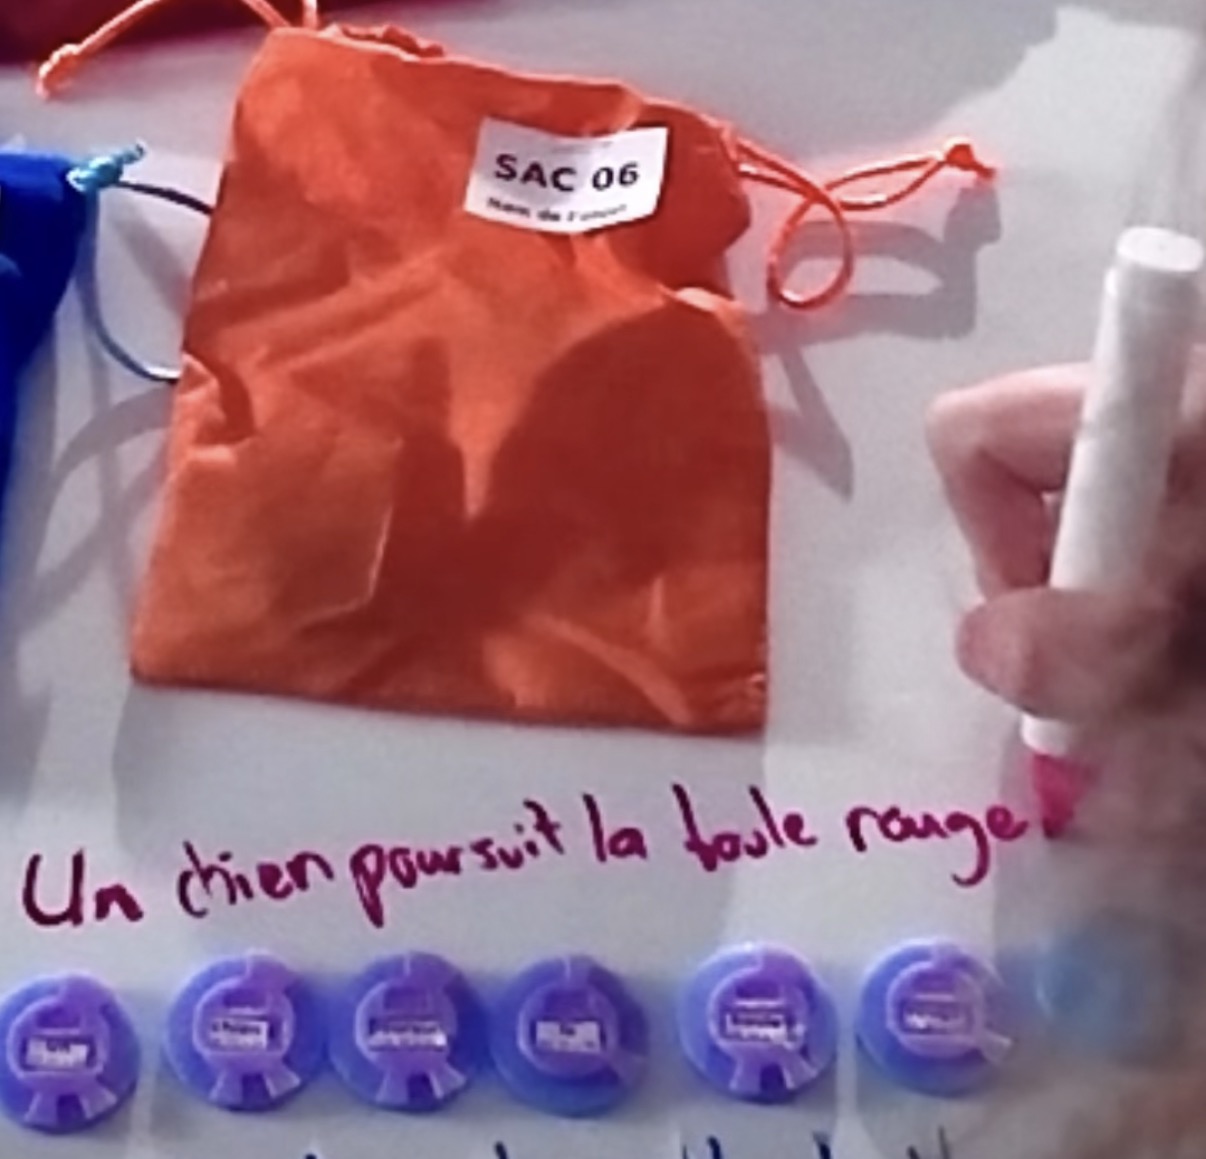
La phrase de l’empreinte numérique stricte : un chien poursuit la boule rouge.
Le résultat n’est pas si mal. On peut maintenant regarder les jetons «rouges» dans le sac noir.
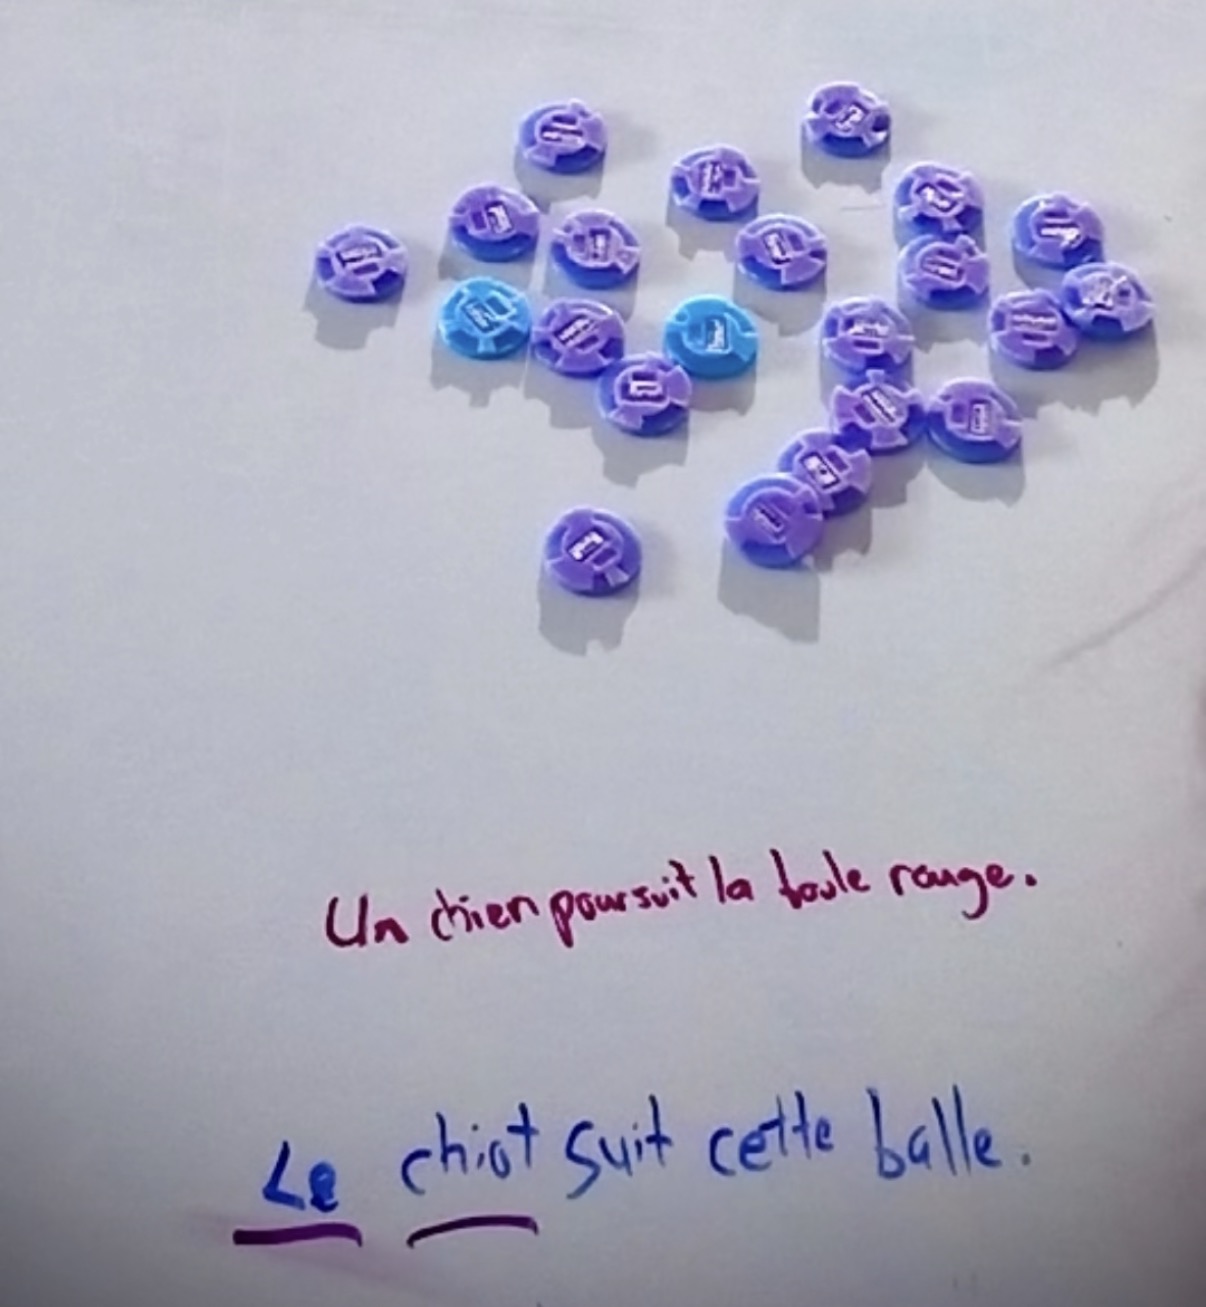
Puisque les jetons «rouges» étaient dans le sac noir et ne pouvaient pas être pigés, ça a fortement réduit la probabilité que certains mots apparaissent dans notre pige de jetons «verts».
À la mesure d’une phrase, l’influence est presque invisible. Mais vous pouvez bien imaginer que dans un texte de plusieurs milliers de jetons, une compagnie d’IA qui connait bien sa clé pourrait avancer avec un haut taux de certitude que la clé à été utilisée, uniquement en regardant la distribution statistique des mots.
C’est ça une signature numérique.
Pourquoi les services tiers de détection échoue : ils posent un diagnostic sans avoir accès à la mécanique.
La compagnie tierce qui fait de l’analyse d’un texte pour déterminer s’il est synthétique n’a accès qu’aux phrases finales, sans contexte supplémentaire sur quelle compagnie d’IA pourrait en être la source, et si elle a utilisé une clé numérique. Une compagnie comme Pangram essaie d’utiliser des modèles mathématiques pour déterminer si un texte est IA tout en devant prendre en compte une possible intervention humaine qui pourrait avoir légèrement modifié les textes soumis, ou qui pourrait être l’unique origine du texte. Dans ces conditions, c’est extrêmement complexe de prouver si un texte est IA, et dans quelle mesure. Leur diagnostic est pour le moins douteux.
Les outils de détection fiables et grand public s’en viennent, merci l’UE!
Les compagnies d’IA ne fournissent pas d’outil grand public pour vérifier une fois pour toute si un texte vient d’eux ou non. Mais ça s’en vient! L’Union Européenne force la main aux compagnies d’IA avec leur loi sur l’IA et l’Omnibus numérique. En vertu de l’article 50, paraphe 2, il faudra que les contenus de synthèse par des compagnies privées correspondants à certains critères assez larges soient dotés d’une empreinte numérique lisible par la machine. Selon le considérant 135, la détection devra être possible par le grand public.
En vertu de l’Article 111(4), les fournisseurs de systèmes générant des contenus de synthèse mis sur le marché avant le 2 août 2026 disposent d’un délai jusqu’au 2 décembre 2026 pour se conformer aux exigences de marquage et de détection de l’Article 50(2). D’où l’annonce d’Anthropic dont je vous ai parlé plus tôt mentionnant qu’une empreinte numérique sera bientôt utilisée.
Des changements importants s’en viennent! Partagez cet article pour commencer à sensibiliser votre réseau à ces questions.